23 octobre 2026
Temps de lecture : 4 min
Un robot qui consulte un article ne rapporte pas nécessairement un lecteur. Il peut alimenter un moteur de recherche, constituer une base de données ou permettre à un assistant IA de répondre à un internaute sans que celui-ci visite le site d’origine. Pour les éditeurs, identifier ces usages devient essentiel. Derrière une même requête automatisée se cachent des conséquences très différentes pour leur activité.
L’Observatoire bots-crawls du GESTE, publié ce mois-ci, donne une idée de l’ampleur du phénomène. Sur le panel de médias français étudié, qui comprend Ouest France, Le Parisien, Les Echos, Challenges, Europe1, Capital, Le Télégramme, Le Figaro, TF1 News, BFMTV, RTL, TV5 Monde et Mind Media, les bots représentent 50 % du trafic global mesuré. L’autre moitié est attribuée aux navigateurs, mais cela ne garantit pas la présence d’un humain : certains programmes automatisés se font passer pour des visiteurs ordinaires.
Tous ces robots ne relèvent pas de l’intelligence artificielle. Les moteurs de recherche traditionnels, les collecteurs de données et les intermédiaires techniques occupent une place importante dans le trafic observé. La part directement attribuée aux grands modèles de langage et aux agents IA représente, elle, 6,5 % du volume global.
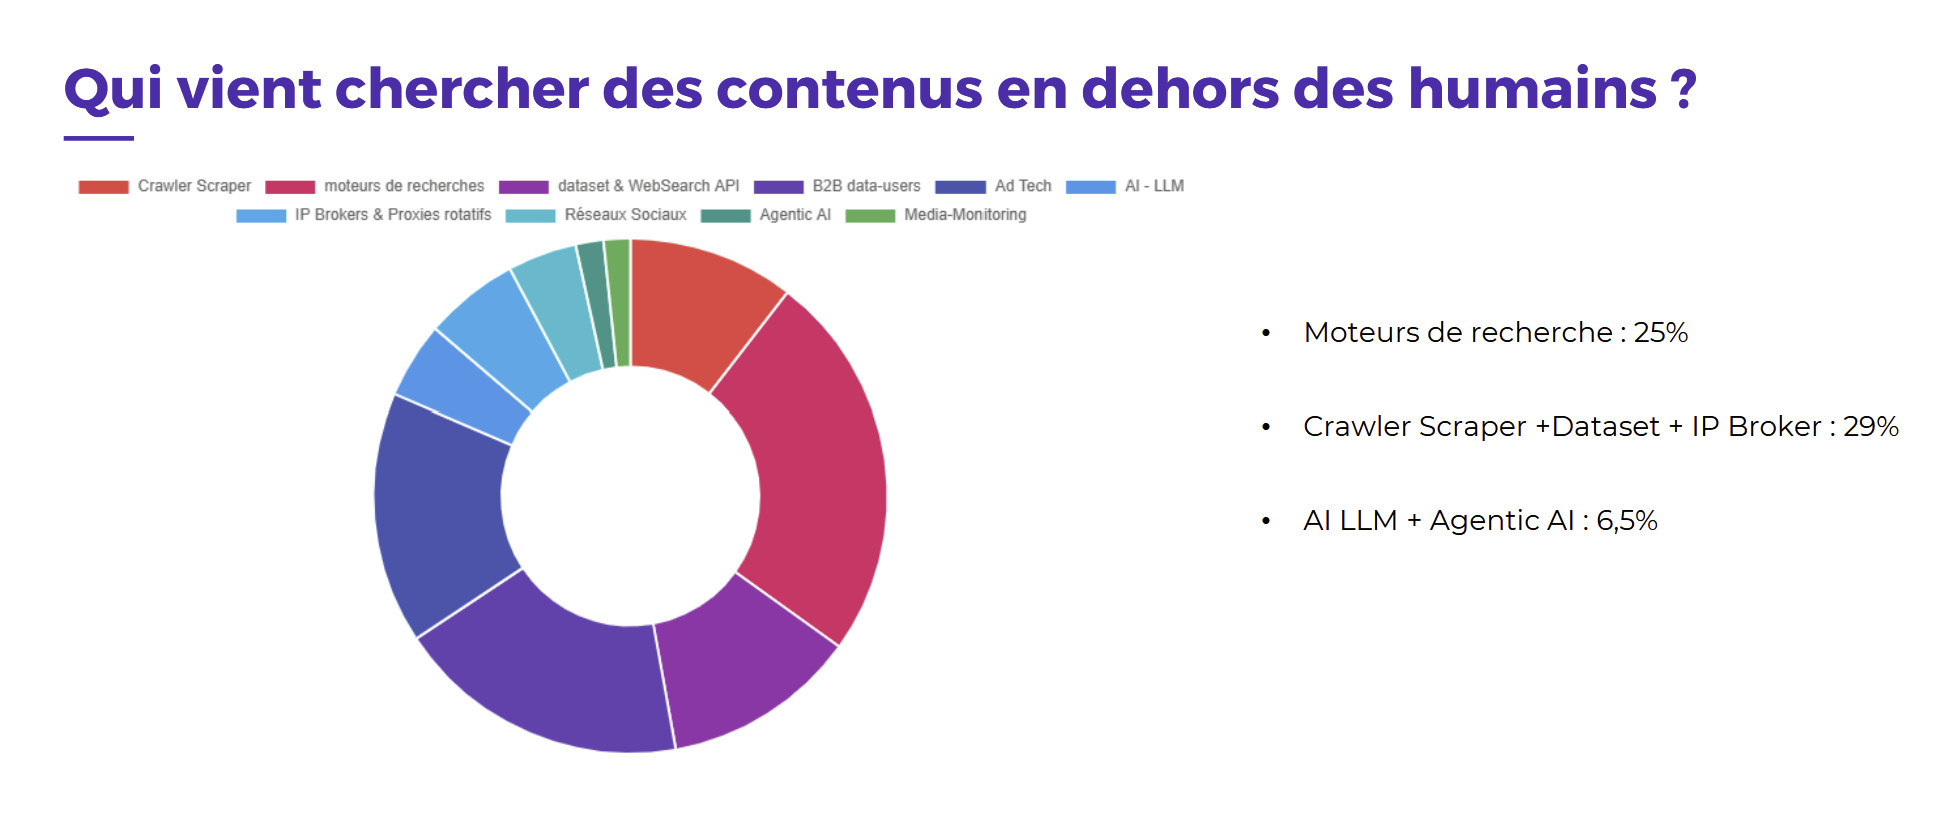
Au sein du trafic IA identifié, OpenAI arrive largement en tête avec près de 60 millions de requêtes sur la période étudiée. Ce volume se répartit principalement entre ChatGPT-User, GPTBot et OAI-SearchBot. Meta suit avec 13,2 millions de requêtes, devant Perplexity, à 7,6 millions, et Anthropic, à 5 millions.
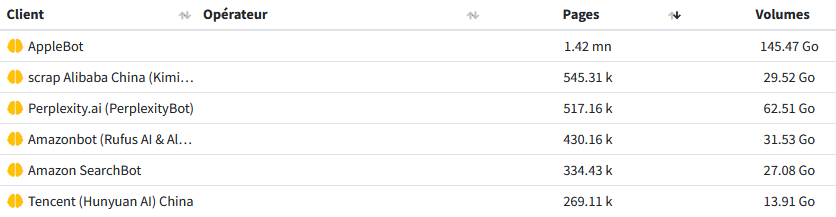
Mais les robots qui affichent leur identité ne constituent qu’une partie du sujet. L’observatoire relève aussi l’utilisation de « faux navigateurs » : des programmes de collecte qui imitent notamment d’anciennes versions de Chrome depuis des infrastructures cloud pour contourner les restrictions d’accès. Cette diversité complique la tâche des éditeurs : savoir qu’un accès est automatisé ne suffit pas à comprendre qui exploite le contenu, ni dans quel but.
Pour Yan Gilbert, fondateur de Botscorner, qui contribue à L’Observatoire du GESTE, l’enjeu dépasse donc la gestion technique du trafic. « Pour les éditeurs de presse, le sujet n’est pas la présence technique des robots en soi, mais l’impact direct de leur activité sur le modèle économique du site ».
Botscorner cherche à cartographier ces accès automatisés : quels acteurs demandent des articles, des images ou des données ? Cette visibilité doit aider les médias à définir leur politique d’accès et à identifier d’éventuels partenaires commerciaux.
« Lorsqu’un acteur vient aspirer vos contenus pour développer un service en concurrence frontale avec le vôtre, la décision logique consiste à le bloquer. En revanche, si ce trafic provient d’un acteur capable d’apporter de la valeur ou d’enrichir votre écosystème, cette visibilité devient le point de départ d’une négociation pour conclure des accords de licence ou des partenariats rémunérés », explique Yan Gilbert.
Cette question prend davantage de poids à mesure que les moteurs et les assistants répondent directement aux internautes. Le contenu d’un éditeur peut contribuer à une réponse sans générer de visite sur son site, et donc sans occasion de monétiser cette consultation par la publicité ou de convertir le lecteur en abonné.
Pour accéder à des informations récentes, les modèles peuvent notamment s’appuyer sur des services de recherche comme Exa.ai. Ces intermédiaires leur permettent de récupérer des contenus sur le Web au moment de préparer une réponse. L’enjeu pour les médias concerne ainsi aussi bien les entreprises qui développent les assistants que les acteurs qui les approvisionnent en informations.
Faut-il, dès lors, prévoir des parcours distincts pour les humains et les machines ? C’est l’approche choisie par The Economist. Le média britannique développe une expérience destinée aux lecteurs, pensée pour favoriser l’engagement et l’abonnement, et une autre adaptée aux agents IA.
Dans cette seconde version, les animations et les mises en page complexes cèdent la place à des textes structurés, à des questions-réponses et à des balises facilitant l’interprétation des informations. L’objectif est de rendre les contenus et les offres plus facilement compréhensibles par les assistants qui consultent le site.
Pour Yan Gilbert, cette distinction est réalisable : « Sur le plan technique, l’existence de deux versions fonctionne à la manière d’un répartiteur de charge : le serveur identifie la nature de l’utilisateur et aiguille l’internaute humain d’un côté et l’agent d’IA de l’autre ».
En revanche, la pertinence économique du dispositif est moins évidente. Faciliter la lecture par une machine ne garantit ni visite supplémentaire ni revenu pour l’éditeur.
« Si une telle organisation présente un intérêt évident pour le e-commerce, où l’agent IA peut directement finaliser un achat, elle s’avère beaucoup plus délicate pour la presse. Si l’agent d’IA vient lire une version dédiée pour résumer l’information et la restituer à l’utilisateur sans générer le moindre clic vers le site d’origine, l’équilibre financier de l’éditeur est directement menacé », prévient-il.
Identifier les robots et contrôler leur accès constitue une première étape. Encore faut-il trouver des acteurs prêts à payer. L’expérience de Cloudflare, sur laquelle Minted revenait en juillet, illustre la difficulté de transformer ce contrôle en revenus.
Selon Stephanie Cohen, directrice de la stratégie de Cloudflare, le blocage des robots a contribué à renforcer le pouvoir de négociation de grands groupes médias. Mais pour les éditeurs qui ne disposent pas des moyens de conclure des accords directs, le modèle reste à construire. Le dispositif de « paiement au crawl », qui permet de fixer un prix pour l’accès à une page, peine notamment à démontrer son efficacité. Sur plus de deux milliards de requêtes associées au code HTTP 402, signifiant « paiement requis », « la grande majorité d’entre elles n’aboutit pas à un paiement », reconnaissait-elle.
Cloudflare explore donc une autre piste avec des acteurs comme Ceramic et You.com : rémunérer les éditeurs lorsque leur contenu est effectivement utilisé pour formuler une réponse. Le paiement porterait ainsi sur l’exploitation de l’information, plutôt que sur sa simple consultation par un robot.
Ces expérimentations prolongent la question soulevée par le fondateur de Botscorner : quelle contrepartie un éditeur peut-il obtenir de ceux qui utilisent ses contenus ? Les outils de contrôle existent, mais le marché de cette rémunération reste largement à bâtir.
Topics
TOUS LES MATINS, RECEVEZ UNE DOSE D'ADTECH, D'EVENEMENTS, D'INNOVATIONS, MEDIA, MARKETING...
Je découvre les newsletters Minted !